← 返回研究
基准 · KDD 2026 主会(CCF-A)· 2026 年 2 月
SWE-Bench Mobile
把 AI 编程智能体放进真实生产 iOS 工程,我们看到了清晰的能力边界。论文已发表于 KDD 2026 主会(应用数据科学方向,CCF-A)。
Muxin Tian, Zhe Wang, Blair Yang, Zhenwei Tang, Kunlun Zhu, Honghua Dong, Hanchen Li, Xinni Xie, Guangjing Wang, Jiaxuan You
Coolwei AI Lab × University of Toronto × Xiaohongshu Inc. × University of Illinois Urbana-Champaign × University of California, Berkeley
2026 年 2 月约 6 分钟阅读
SWE-Bench Mobile 把"智能体写代码"的评测从开源 GitHub 仓库搬进了一款真实在线的移动产品。50 个工程任务全部来自小红书生产 iOS 应用,每个任务配上原始 PRD、Figma 设计稿与人工写的测试套件,让智能体像真正的 iOS 工程师那样读多模态规格、改一个约 50 万行的 Swift / Objective-C 混合代码库。
结果给出了清晰的能力边界:即便是商业上最强的智能体 + 模型组合,也只能解决 12% 的任务。而且,选哪个智能体和选哪个模型同等重要:同一个模型换个脚手架(scaffold,驱动模型读码、改码、跑测试的智能体框架),通过率能差出 6 倍。好比同一位大厨换一间厨房,出品也会大不相同——灶台与流程的影响,和厨艺本身一样真实。论文已发表于KDD 2026 应用数据科学方向(主会,CCF-A 顶会)。
KDD 2026 · 韩国济州岛
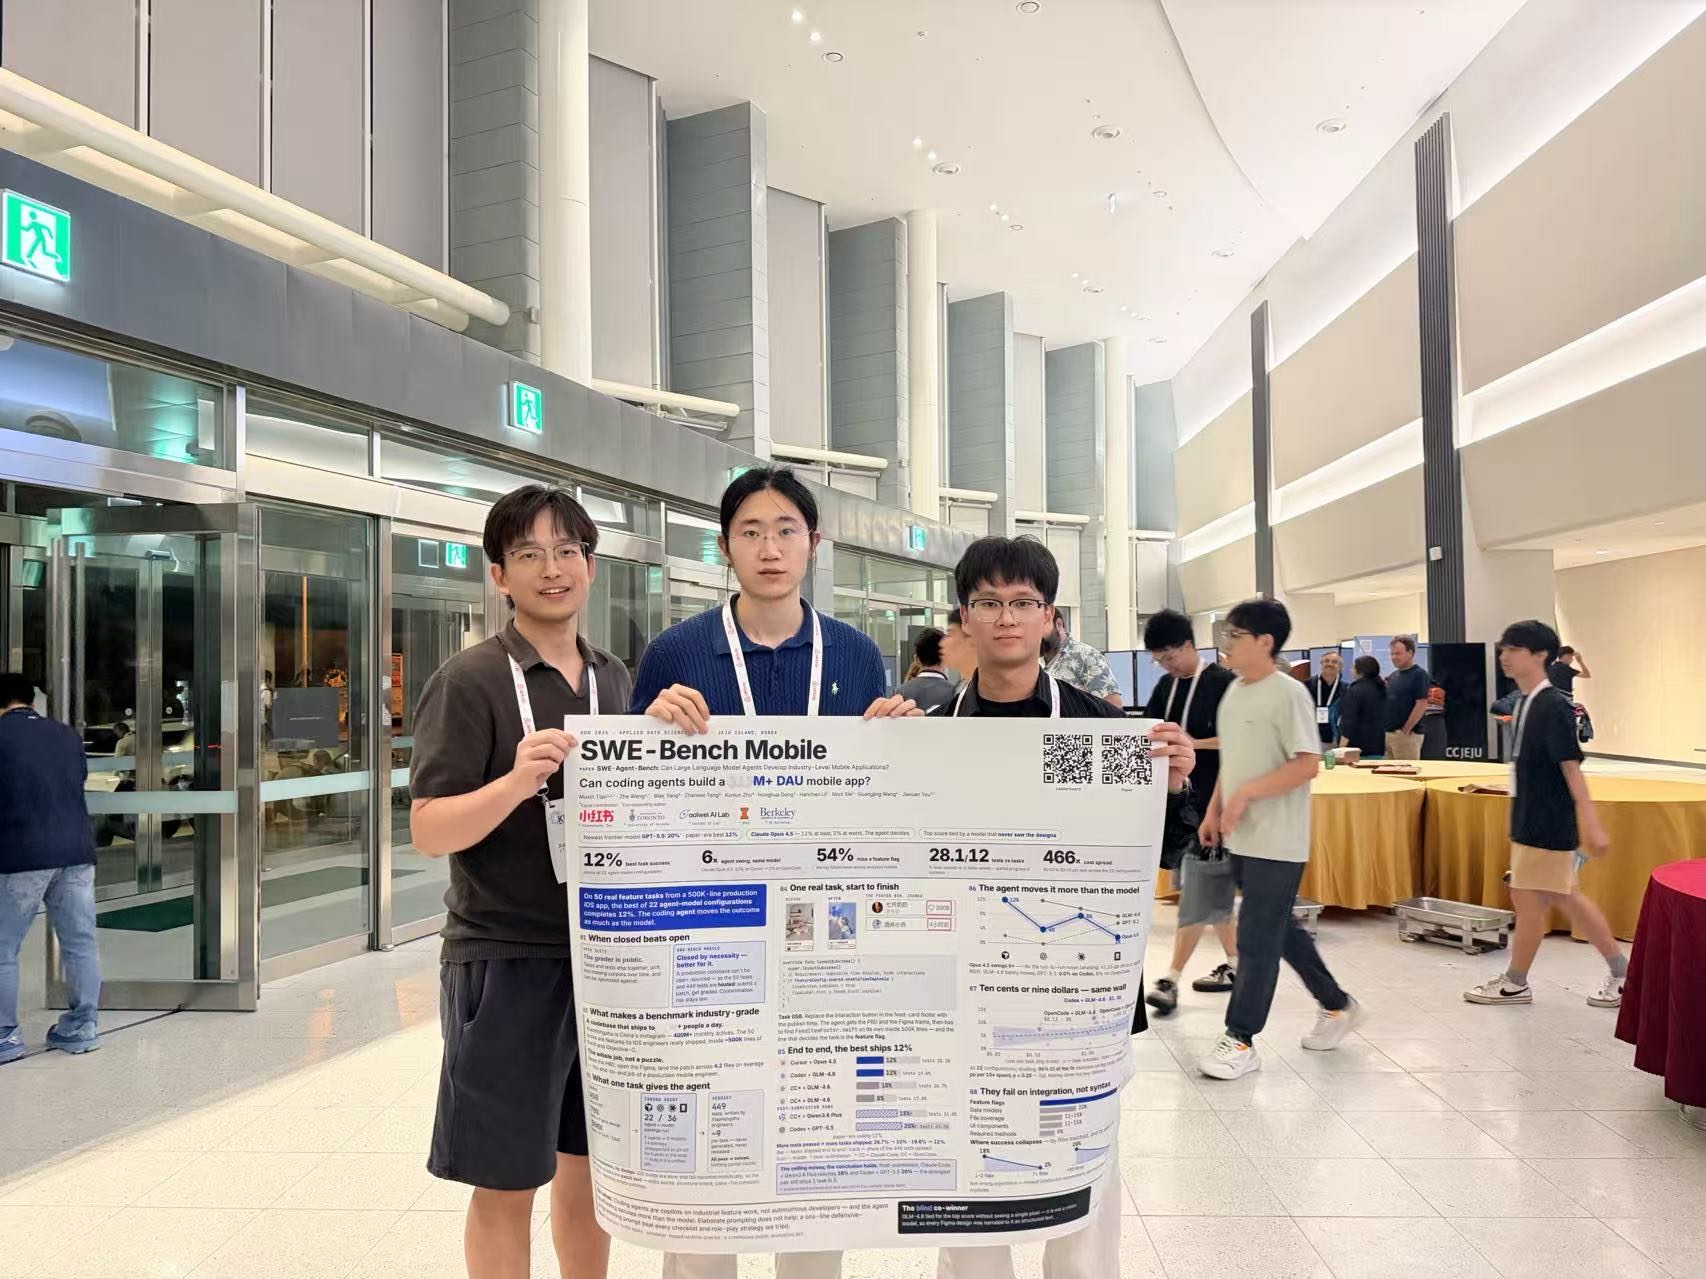
作者团队成员在 KDD 2026 会场与 SWE-Bench Mobile 海报合影。
据论文重绘。一个真实产品需求以 PRD + Figma + 代码库快照的形式进入;智能体写出补丁;补丁由入口、功能、配置三类评测器对照人工测试套件打分。
为什么需要它
既往的智能体编程基准在四个维度上都"低估"了真实工程:开源仓库可能被预训练污染;任务多是修 bug 而非加功能;规格是 GitHub issue 而不是设计文档;测试通常已经存在。SWE-Bench Mobile 把这四点全部反过来——代码库是一款真实的生产 iOS 应用,任务是带 PRD 和 Figma 的功能新增,评测平台只在线运行,测试集不公开下载,从机制上降低数据污染风险。
一句话:SWE-Bench Mobile 要回答的问题是——智能体能不能读懂真实需求、理解设计稿、找到正确模块,并把改动稳妥地合入一个生产级移动工程。
基准构成
| 来源 | 小红书生产 iOS 应用 |
| 编程语言 | Swift + Objective-C(混合) |
| 任务数 | 50 |
| 测试用例 | 449(约每任务 9 条) |
| 代码规模 | 约 50 万行 |
| 每任务输入 | PRD + Figma 设计 + 代码库快照(多模态) |
| 输出 | 统一 diff |
| 视觉素材 | 35 个任务包含 Figma 设计,46 个任务包含参考图 |
| 任务分布 | UI 组件 18 · 数据管理 10 · 手势交互 8 · 媒体资源 7 · 网络 4 · 其他 3 |
| 任务类型 | 功能新增(非修 bug) |
| 评测方式 | 仅线上托管(防污染) |
基准组成。"任务类型"是与既往智能体基准最大的差别:功能新增逼着智能体去构建,而不只是修。
据论文重绘。任务构成。UI 组件、数据管理与手势交互覆盖大半数据集,配有经过校准的难易分布。
据论文重绘,为示意图。一个代表性任务。每个任务都配有改动前后的截图、Figma 设计稿以及一份真实代码 diff——智能体需要写出能通过测试套件的补丁。
主要结果
我们评测了 22 种智能体–模型组合,覆盖 4 个智能体(Cursor、Codex、Claude Code、OpenCode)与若干领先的商业及开源模型。排行榜头部如下:
| 智能体 + 模型 |
任务通过 |
测试通过 |
| Cursor + Claude Opus 4.5 | 12.0% | 28.1% |
| Cursor + Claude Sonnet 4.5 | 12.0% | 26.7% |
| Codex + GLM 4.6 | 12.0% | 19.6% |
SWE-Bench Mobile 排行榜头部。前三名"任务通过率"并列 12%,但"测试通过率"差出 8.5 个百分点——这是粗粒度通过 vs 细粒度能力的差距。最新结果见 swebenchmobile.com。
据论文重绘。完整排行榜。22 个组合,三名并列榜首,长尾停在个位数。榜首值得说,长尾同样值得看。
据论文重绘。同一个模型,四个智能体。Opus 4.5 从 12%(Cursor)一路掉到 2%(OpenCode)。脚手架决定的成败,和模型本身一样多。
关键发现
- 同一个模型,不同智能体——最大差出 6 倍。"脚手架"在重要性上几乎与模型本身相当。
- 简单提示赢过复杂提示。一句"防御式编程"提示比更精巧的提示策略多 7.4 个百分点。
- "测试通过率"这一栏值得看。表面上"失败"的任务往往通过了相当一部分测试——只看 pass@1 就会丢掉这部分信号。
- 复杂工程仍是短板。需要跨 7 个以上文件的任务成功率仅 2%,小补丁任务明显更容易通过。
- 生产部署知识会卡住智能体。常见失败包括遗漏 feature flag、数据模型、关键文件、UI 组件和必要方法。
同一个模型在不同智能体里能差出 6 倍。只报模型名的评测,漏掉了一半变量。
据论文重绘,数值为近似值。成功率下滑最陡的地方。补丁要跨越的文件越多、改动行数越大,成功率越往下掉。跨模块工程仍然是没被攻克的部分。
据论文重绘。类别 × 智能体热力图。每个智能体有自己擅长的形状,没有一个全面最强,也没有一个全面最弱。
据论文重绘。多次跑分的稳定性。具体数字会在跑分间波动,但智能体 + 模型组合之间的排序稳得足够拿来横向比较。
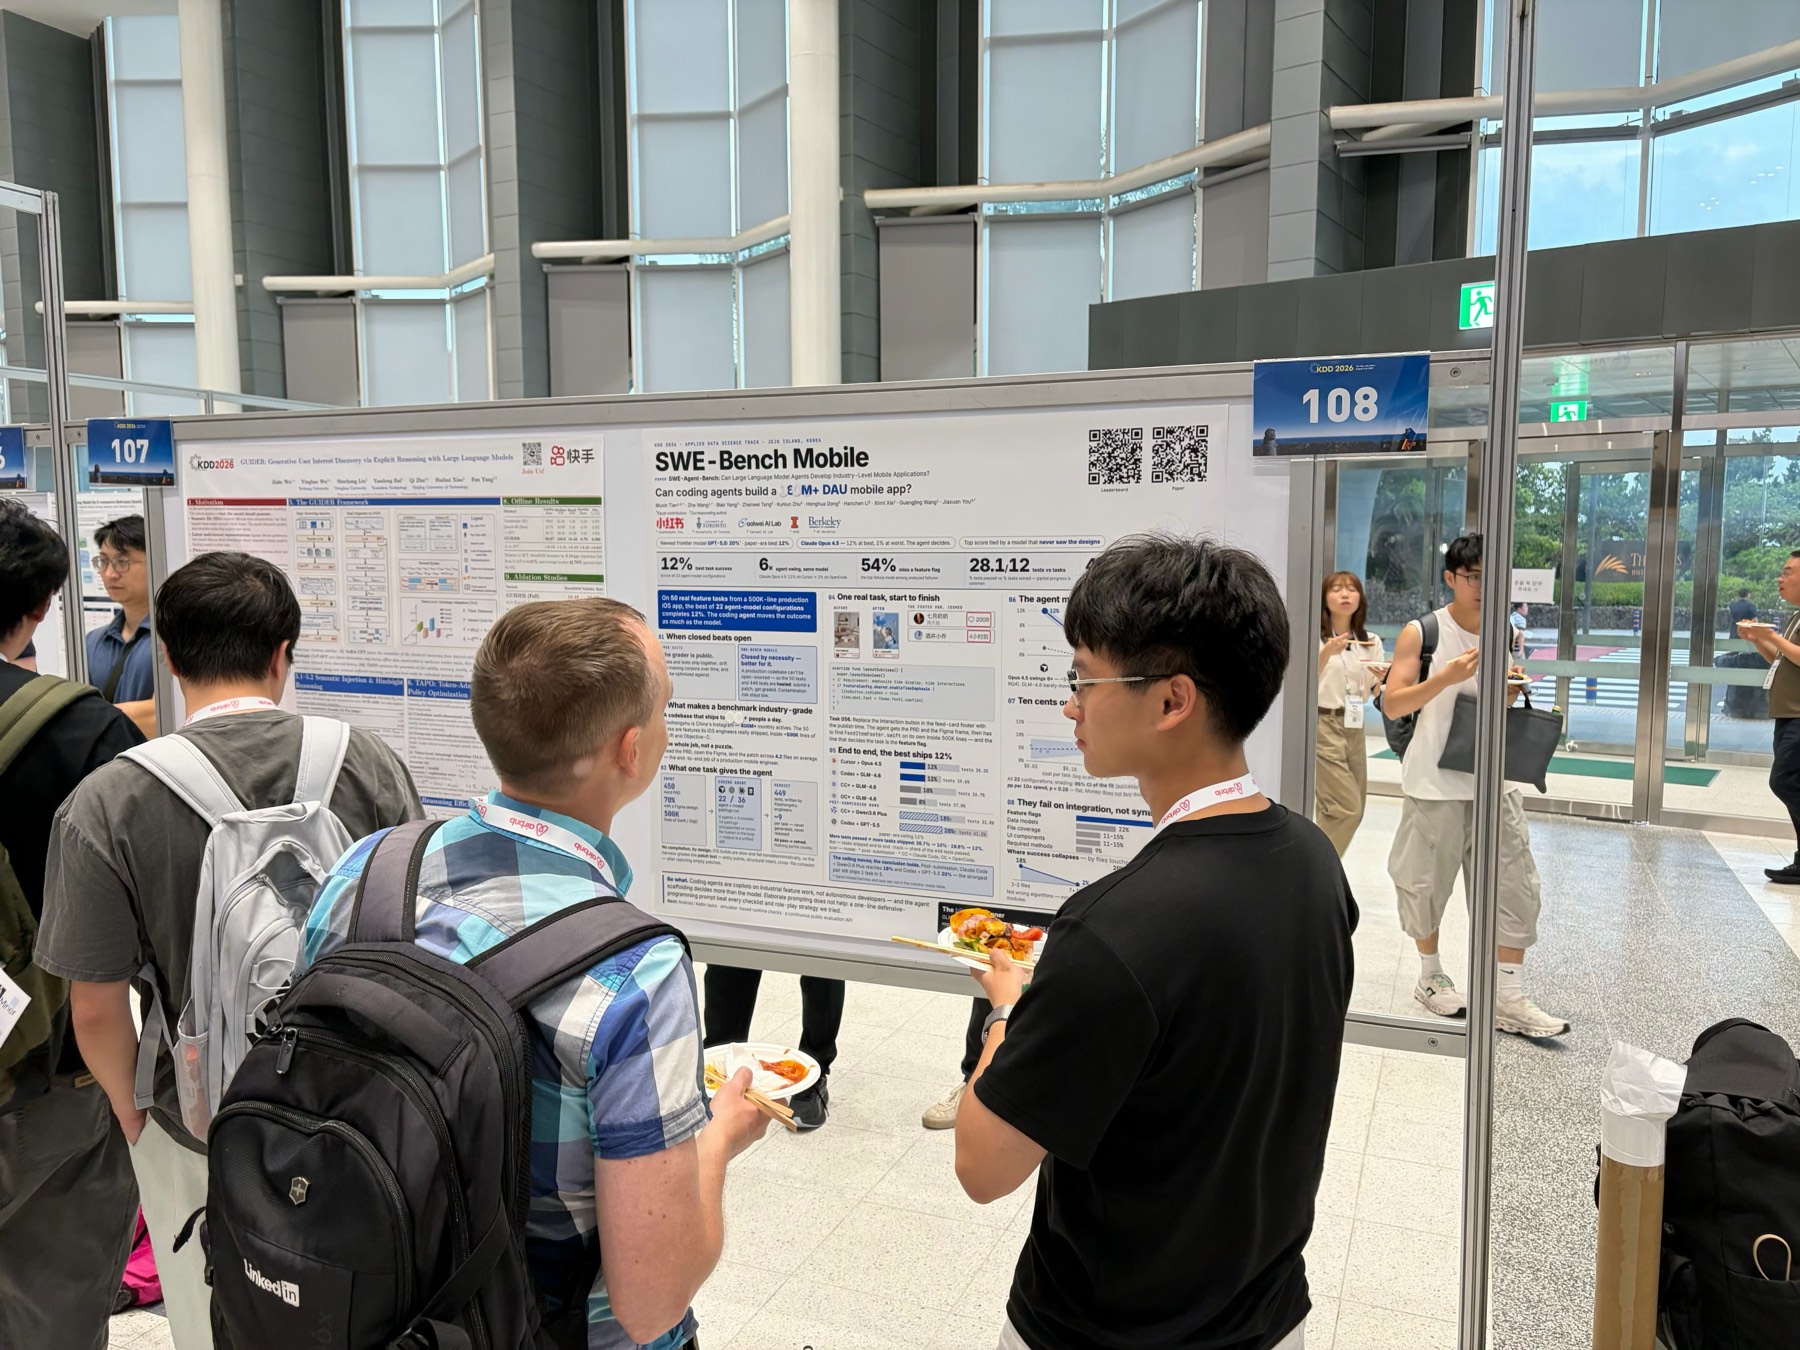 KDD 2026 海报环节现场。论文发表于 KDD 2026 主会应用数据科学专题(Applied Data Science Track)。
意义
第一个"生产级"智能体编程基准。
任务来自一款真实在线的 App,而不是精心整理过的开源 issue。代码库、规格(PRD + Figma)、测试都是真实的——意味着 12% 的榜首分数货真价实——而且它大概率还美化了智能体与独立工程师之间的真实差距。
智能体很重要,不仅仅是模型。
同模型最大差出 6 倍,意味着把"模型 X"当成自变量、把脚手架当成透明层的评测范式是有偏的。"智能体 + 模型"才是真正可比的单元。
仅线上托管,是有意为之的设计。
提交在服务器端运行,测试集不会泄漏进训练数据——这是一种刻意抬高门槛、因而抗污染的工业基准范式,对其他领域同样有借鉴意义。
给行业的信号
这个读数相当积极。12% 的严格任务通过率说明,当前智能体距离"独立客户端工程师"还有明显距离;但最高 28.1% 的测试通过率也说明,它们已经能在真实工程里干出一部分活。更准确的定位是:AI 编程智能体正在成为有用的 Copilot,还不是可以无人监督接管复杂移动端迭代的 Auto Developer。
参与评测
托管挑战、公共排行榜,现已开放提交:在同一套真实生产 iOS 任务上评测你的“智能体 + 模型”,与现有榜单直接对比。论文已发表于 KDD 2026 主会(CCF-A)。